AI Digest

AI・LLMの最新ニュースを毎朝日本語でまとめてお届けします

AI・LLMの最新ニュース(2026-10-16)

MetaとNVIDIAが、手元のマシンで動かせるオープンウェイトモデルを同じ日に出した。ローカル推論の選択肢が一気に増えている。規制と監督の面では、FTCがAnthropicとOpenAIを調査していると報じられた。AnthropicはMETRに社員並みのアクセス権を与えている。開発の現場からは、SDKの挙動変更、AIが生むコード量にレビューが追いつかない問題、無人エージェントの利用上限対策といった実務的な話題が出ている。

Meta、オープンウェイトのマルチモーダルMoEモデル「Muse Spark Open」を公開 Appleと組みMacでのローカル実行に対応

必読モデル/リリースHugging Face · Welcome Muse Spark Open: open-weight frontier multimodal mixture-of-experts model from Meta

Metaが「Muse Spark Open」を公開した。オープンウェイトのマルチモーダルMixture-of-Expertsモデルで、Hugging Faceで配布されている。Meta自身は「米国製オープンウェイトモデルで最も高性能」と主張しており、Appleと協力して最新のMLXを使えばM5 Ultra搭載Mac Studio 2台で動くとしている。フロンティア級をうたうモデルがクラウドを使わずにデスクトップで動くことになり、機密データを扱う検証環境の選択肢が広がる。
NVIDIA、Nemotron 3.5を拡充 120Bの「Super VL」とローカル向け「Bolt」2種を公開

必読モデル/リリースNVIDIA · Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models

NVIDIAは、120BパラメータのオープンモデルNemotron 3.5 Super VLを公開した。あわせて、エッジ向けにNemotron 3.5 Bolt 74B-A9B(24GB)とBolt E4B(4GB)の2種も出している。Super VLのタスク完了速度と精度が最高水準だというのはNVIDIAの主張だ。名前に必要メモリ量が入っており、24GBのGPUや小型デバイスでエージェントを動かしたい人は、自分の機材に合うか判断しやすい。

anthropic SDK(Python)1.14でstream()のイベントが増える条件を検証

注目開発者向け/APIZenn (LLM) · anthropic SDK 1.14 で stream() に届くイベントが増える条件

anthropic-sdk-python v1.14.0では、stream helperが未知のイベント型をそのまま通すようになった。message_startより前に届いたイベントでも例外を出さなくなっている。筆者は1.13.0と1.14.0に同じSSEモックを流し、挙動の違いを確かめた。`for event in stream:` でイベント型を決め打ちしているコードは、更新すると想定外のイベントを受け取る可能性がある。アップグレード前に分岐処理を見直しておくとよい。

FTCがAnthropicとOpenAIを調査か 報道

注目規制/リスクArs Technica AI · Report: FTC probes Anthropic, OpenAI after Trump dismissed AI fears as “hoax”

Ars Technicaによると、米連邦取引委員会(FTC)がAnthropicとOpenAIを調査している。データ侵害の報告を遅らせた企業と同程度の罰金を科す可能性もあるという。トランプ大統領がAIへの懸念を「でっち上げ」と切り捨てた後のことで、政権の姿勢とは別に規制当局は動いていることになる。どちらも報道ベースで、調査の対象範囲はまだはっきりしない。

Anthropic、外部評価機関METRに社員並みのアクセス権を付与 公表の拒否権も手放す

注目規制/リスクTechCrunch AI · Anthropic is letting METR researchers look under the hood with employee-level access

AnthropicはAI安全性評価機関のMETRに、社員と同等のアクセス権を与えた。METRはAnthropicのリスク、インシデント、社内の運用について独自の評価を公表する。Anthropicはその公表を止める権利を放棄した。モデル提供元が自分で出す安全性レポートとは別に、外部の検証結果が読めるようになる。

「1年で生産性2倍」をAIで目指した企業の開発者802人を追跡 CMU・スタンフォードなどが論文

注目研究ITmedia AI+ · CTOが「AI導入で生産性を1年で2倍に」掲げた企業のその後 米国が開発者802人の進捗を追跡調査

CTOがAI活用による生産性2倍を義務づけたソフトウェア企業について、カーネギーメロン大学やスタンフォード大学などの研究者が開発者802人を追跡調査した。論文タイトルは「AI Writes Faster Than Humans Can Review」。コードを書く量が増えても、人間のレビューがそれに追いつかないことを示唆している。AIコーディングを全社に広げようとしている組織にとって、どこがボトルネックになるかを考える材料になる。

国内WebサイトへのAIエージェント攻撃を観測 1件は8時間弱で10段階に手口を変化

注目規制/リスクITmedia AI+ · 国内WebサイトへのAIエージェント攻撃を観測 「8時間弱」続いた攻撃の推移を公開 国内セキュリティベンダー

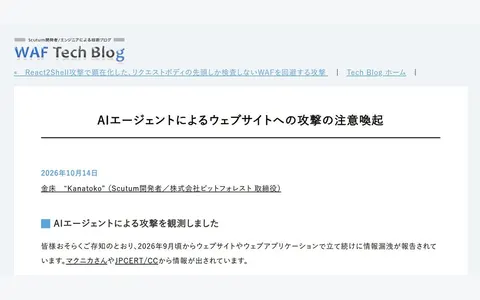
国内セキュリティベンダーのビットフォレストが、日本企業のWebサイトに対するAIエージェントによる攻撃を観測したと報告した。10月14日までに3つのIPアドレスから攻撃があった。そのうち1つは8時間弱にわたって続き、手口を10段階に変えていたという。人手では続かないような長時間の試行錯誤が自動で行われている。WAFの設定やログ監視は、相手が粘り続ける前提で見直したほうがよい。

SB Intuitionsの国産LLM「Sarashina」API無償ベータを試す sarashina3-miniで日本語推敲を検証

注目モデル/リリースZenn (LLM) · 国産モデル sarashina3-mini は日本語の推敲で何を変えるのか?

SB Intuitionsは10月13日、国産LLM「Sarashina」をAPIで使える「Sarashinaサービス」の無償ベータを始めた。この記事では、標準の対話モデルsarashina3-miniに日本語の文章を書かせ、推敲もさせている。前回の記事で試したGeminiの結果とも見比べている。日本語に強い国産モデルを費用をかけずに業務で試せる期間なので、評価の進め方の参考になる。

ChatGPTのChrome拡張が強化 開いているタブを参照可能に

注目プロダクト/ツールThe Verge AI · ChatGPT can peek at your Chrome tabs now

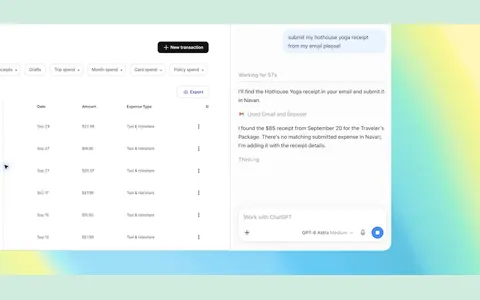
OpenAIはChatGPTのGoogle Chrome拡張をアップデートした。ChatGPTのWeb版やデスクトップアプリでChromeをタグ付けすると、ブラウザで開いているタブの内容をChatGPTが読めるようになる。独自ブラウザのChatGPT Atlasは終了しており、ブラウザ連携は既存のChromeを使う形に切り替わった。普段使っているブラウザのまま調べものや比較ができるようになる一方、どのタブを見せるかは自分で管理する必要がある。

Figma、プラットフォーム上でのエージェントの動作を定義する新機能を発表 code layersはオープンベータに

注目プロダクト/ツールTechCrunch AI · Figma announces new features to define how agents work on its platform

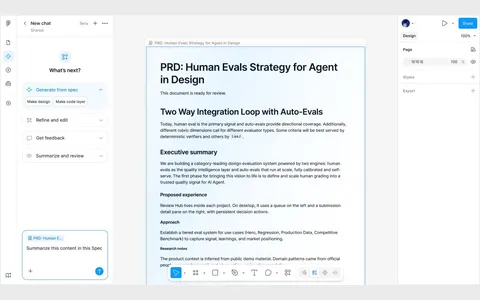
Figmaは、AIエージェントがFigma上でどう作業するかを定める新機能を発表した。デザインとコードを同じ場所で扱える「code layers」もオープンベータとして公開している。デザインデータをエージェントに渡して実装させるワークフローを、Figma側が公式に用意し始めた。デザインから実装への受け渡しを自動化したいチームは、自分たちの手順に組み込めるか試すとよい。

Anthropic、四半期売上が約50%増の168億ドルと投資家に説明 IPOを前にFTが報道

注目ビジネス/業界動向Simon Willison · Anthropic tells investors quarterly revenue up nearly 50% to $16.8bn ahead of IPO

FTが関係者の話として報じた。Anthropicの第3四半期売上は168億ドルで、前の四半期の115億ドルから50%近く伸びた。計算資源に1ドル使うごとに売上は1.70ドルで、株式報酬を除いた調整後営業利益率は11%だという。公式発表ではなく投資家向けの説明内容だが、APIの価格や供給の持続性を見るうえで数少ない手がかりになる。

Claude Codeを夜間に無人実行したら1週間で3回停止 利用上限を前提にした4つの設計変更

開発者向け/APIZenn (LLM) · Claude Code を夜間に無人実行させたら1週間で3回止まった——コスト設計で変えた4つのこと

筆者は23時に処理をまとめて動かす設計でClaude Codeを無人実行していた。最初の1週間で3回止まり、原因はすべてClaude Proの利用上限(429/529)だった。記事では実行ログから止まる時刻のパターンを分析し、容量管理のために変えた4つの判断をまとめている。同じ日には、週次リミットで無人起動が2日続けて失敗した別の記録も出ている。サブスクリプション枠でエージェントを自動運用するなら、上限に当たることを前提に設計しておく必要がある。