GPT-6.1 SolにUltrafast追加、評価は「最初の表示」と「生成中の速さ」を分けて測る
OpenAIは10月8日、Responses APIのGPT-6.1 SolにUltrafastを追加しました。OpenAIの説明では、狙いは出力トークン同士の間隔を縮めることです。最初の1文字が出るまでの待ち時間を縮める機能ではありません。紹介記事は、最初の表示・生成中の速度・完了通知までの3区間を分けて集計するツールを作っています。総所要時間だけで比べると、改善の有無を見誤るためです。
AI・LLMの最新ニュースを毎朝日本語でまとめてお届けします
OpenAIは10月8日、Responses APIのGPT-6.1 SolにUltrafastを追加しました。OpenAIの説明では、狙いは出力トークン同士の間隔を縮めることです。最初の1文字が出るまでの待ち時間を縮める機能ではありません。紹介記事は、最初の表示・生成中の速度・完了通知までの3区間を分けて集計するツールを作っています。総所要時間だけで比べると、改善の有無を見誤るためです。
CLMは、言語モデルが自分のコンテキストを自分で編集・管理する手法です。これまでは要約・圧縮・検索といった外付けの仕組みに任せていました。研究チームは、性能と計算効率の両方が大きく改善したと報告しています。長時間動くエージェントのメモリ管理を自前で作っている場合、どこまでをモデルに任せられるかを見直す材料になります。
筆者はスマートグラスに字幕と用語解説を出すアプリを作り、費用を試算しました。1時間あたり約5.4ドルで、大半は同じ長い指示文を毎回送り直す分でした。キャッシュが効く条件は2つあります。プロンプトが一定の長さを超えること、毎回変わる部分を末尾に置くことです。中身を変えずに可変部分を前へ移しただけで、キャッシュの割引は72%から0%に落ちました。必要な最小長はモデルや送り方によって異なるため、自分の呼び出し方で実測するよう勧めています。
TypeSafe AIは9月15日、System Oneモデルの第1弾としてJevを早期アクセスで公開しました。Jevは文章を書きません。システムの状態を受け取り、型の付いた確率的な判定を返します。同社は、チャットモデルを自動化に使う問題点として、応答に3〜329秒かかること、出力のパースと検証が必要なこと、脱線しうることを挙げています。LLMの出力をJSONスキーマで縛って分岐処理に使っている開発者には、別の選択肢になります。
Apple Silicon専用の推論エンジンUzuについて、10月9日に「16GBのM5でllama.cppの約4倍」とする測定が広まりました。記事の筆者が同じM5 16GBで測り直すと、初期設定のままではPythonコード生成で約86〜88 tok/s出ました。一方、投機的デコードを外すと27 tok/s程度に下がり、日本語の文章生成でも数値が落ちました。速さの大部分は投機的デコードによるもので、出力の種類によって伸び幅が変わります。乗り換えを検討するなら、自分の用途で測る必要があります。
筆者は、コンパイラもアセンブラも使わせずに小さなルーチンを機械語で書かせる試行をしました。対象はx86-64とAArch64の計8課題、各2回です。結果は、Claude Haiku 4.5が16回中1回、Haiku 5.5が13回の正解でした。Sonnet 5.5とOpus 5.5は、Haiku 5.5が落としたAArch64の課題も解いています。試行数の少ない個人の検証です。それでも小型モデルの世代間で、低レイヤーの正確さに大きな差が出ることがわかります。
筆者の環境では、Claude Codeの新規セッションは開始直後からコンテキストの約10%が埋まっていました。主な中身はCLAUDE.md、メモリ、SessionStartフックとプラグインの注入で、最も膨らんでいたのはプラグインです。プラグインをスキルに置き換えても軽くはなりませんでした。そこで、タスクごとに必要なスキルだけをsymlinkで配る方式に変え、無人タスクで毎回かかるコストを減らしています。
会議記録に質問できるRAGで、承認済みの決定について聞いても「記録に見当たりません」と返る不具合が起きました。原因は質問文中の「確認」という語です。この語は字句検索で大量の文書に当たり、RRFで融合する際に関係の薄い文書が二重に上位へ入って、正解を押し出していました。対策として、出現する文書の数(DF)が多すぎる語を足切りしています。ハイブリッド検索を組んでいる人なら、同じ症状を点検できる事例です。
FileMaker・古い.NET・PHPといったレガシーシステムを移行前に棚卸しする方法の解説です。筆者は、システム全体をLLMに渡して仕様書を書かせる方法をとりません。まず機械的に取れる構造情報を証拠として固め、LLMにはその証拠から仮説を立てるところまでを任せます。どの記述も元のファイルまでたどれることを共通ルールにしている点は、LLMを使った移行調査の進め方としてそのまま使えます。
OWASP Top 10 for LLM Applicationsの項目を、社内チャットボットのような身近な場面に置き換えて説明する連載です。LLM01では、ユーザー入力やWebページに埋め込まれた指示でAIの動作が乗っ取られる仕組みを扱います。LLM02(idx 18)は、アクセス権のない社内文書や他の顧客の情報が回答に混ざるケースです。AIを導入する前に、非エンジニアの関係者とリスクを共有する資料として使えます。
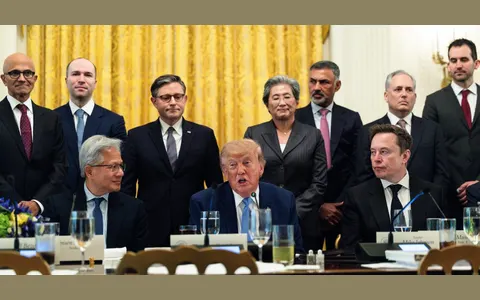
トランプ大統領は、AIを「super intelligence」と呼び替える方針を打ち出しました。一般には定着していませんが、The Vergeによると、シリコンバレーの有力者の一部がこの呼び方を使い始めています。技術的な中身は変わりません。ただ、米国の政策文書や企業の発表で用語が変われば、情報を追うときの検索語や読み方に影響します。
TechCrunchのポッドキャスト「Equity」が、米国各地で広がるデータセンター建設のモラトリアム(一時停止)を取り上げました。業界が秘密保持契約(NDA)で計画を伏せてきた進め方が、反発を強めている可能性を議論しています。計算資源の増強が地域の合意形成で止まれば、中長期的にはAPIの供給量や価格に跳ね返ります。