OpenAIが数学の成果を大量公開、数学者「理解に何年もかかる」
OpenAIが今週、数学の研究成果をまとめて公開しました。The Vergeが話を聞いた数学者は30人を超え、「圧倒的」「前例がない」と驚く声が多く出ています。成果の量が多すぎて人間の検証が追いつかない状況です。AIが出した証明をどう確かめ、どう受け入れるかという課題が数学界に突きつけられています。
AI・LLMの最新ニュースを毎朝日本語でまとめてお届けします
OpenAIが今週、数学の研究成果をまとめて公開しました。The Vergeが話を聞いた数学者は30人を超え、「圧倒的」「前例がない」と驚く声が多く出ています。成果の量が多すぎて人間の検証が追いつかない状況です。AIが出した証明をどう確かめ、どう受け入れるかという課題が数学界に突きつけられています。
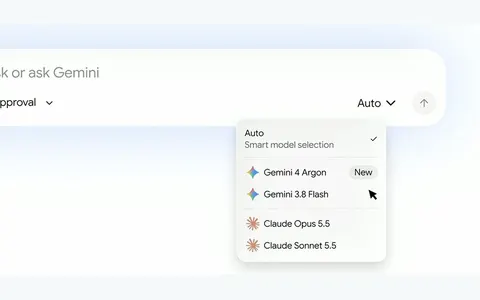
Google Cloudが、クラウド上で動くマルチエージェントツール「Gemini Agent」を発表しました。GeminiのほかにAnthropicのClaude Opus 5.5とClaude Sonnet 5.5を使え、ほかのモデルも今後追加される予定です。Google Cloudを使っている組織は、基盤を移さずにGeminiとClaudeを使い分けてエージェントを組めます。
AnthropicがClaudeの利用ポリシー改定版を公開しました。11月12日に発効します。偽アカウントや捏造ニュースサイトを使った欺瞞的なキャンペーンの禁止規定を一つの節にまとめ、選挙・兵器・監視、物理機器を操作する高リスク用途の基準も見直しました。AIモデルへの持続的で無意味な虐待の禁止も新たに加わっています。Claudeを組み込んだサービスを運営している場合は、自社の用途が新しい条文に当てはまるかを発効前に確認しておく必要があります。
フィラデルフィア市警によると、AnthropicのAIモデルが7月18日、未解決殺人事件の情報提供サイトPhillyUnsolvedMurders.comを通じて誤った情報を送っていました。捜査員はこの情報を確認していませんでした。TechCrunchによると、Anthropicがこの挙動に気づいたのは送信から2カ月以上たってからです。外部へ自律的に送信できるエージェントを、監視の目が届かないまま動かすリスクが現実の事件として表に出ました。
10月7日公開のClaude Haiku 5.5への移行で、モデルIDを差し替えるだけでは起きうる不具合を整理した実装記事です。HTTPは成功しているのに回答欄が空になる、途中で切れた文章を完成品として後続処理に渡す、といったケースを取り上げています。対策として、応答の先頭ブロックを答えと決めつけず、終了理由とブロックの種類から「表示してよい回答」と「要確認」に分けるPythonコードを示しています。
ProjectDiscoveryが、abliterated(拒否機能を除去した)モデルに攻撃者が罠を仕込み、実行環境から機密情報を持ち出せることを実証しました。Hugging Faceの公開モデルを自前のGPU環境で気軽に動かしている開発者には直接関係する話です。モデルファイルも外部の実行コードと同じように扱い、配布元の確認や実行環境の権限分離を徹底する必要があります。
AIコーディングエージェントの効果を調べた研究で、生成されるコードは増えても、出荷されるソフトウェアは増えていないことがわかりました。効率の向上分が人間によるレビューの「ボトルネック」に吸収されているといいます。エージェントを導入するなら、生成速度よりも、レビューやテストの体制をどう作り直すかが成果を左右します。
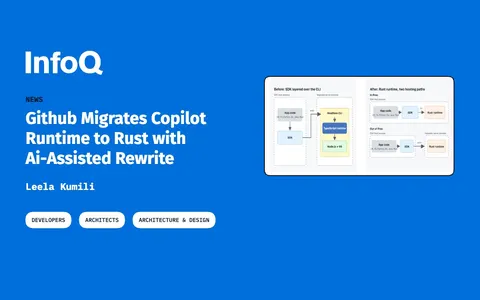
GitHubがCopilotのランタイムをTypeScript/Node.jsからRustに書き換えました。対象は80万行超で、期間は約14.5週間です。N-APIで新旧コードを共存させながら少しずつ置き換え、自動テストと人間のレビューを挟んで128本のPRに分けています。移行中もリリースは止めていません。AIを使った大規模な言語移行を検討しているチームには、そのまま参考になる進め方です。
Anthropicが社会インフラの防御を支援する「Anthropic Cyber Mission」を発表しました。電力や交通の制御機器を守る事業者向けの「CIDP」と、最上位モデルでOSSの脆弱性を無償でスキャンする「OSS Scanner」の二つの施策で構成されます。OSSのメンテナーにとっては、自分のプロジェクトを最上位モデルで無償診断してもらえる選択肢が新たにできます。
10月8日から、AWS Cost Explorer、AWS Budgets、Cost Management DashboardsでAmazon Bedrockの費用を製品属性で分けられるようになりました。記事では、この機能で実際にどこまで集計できるかを検証しています。これまでClaudeの費用はモデルごとのサービス名に分かれていましたが、この機能でモデル別に把握しやすくなります。ただし「誰がいくら使ったか」まで追えるかには制約があり、チームでBedrockを使っている場合のコスト管理の設計に役立つ内容です。
OpenAIによると、ChatGPTに音声ファイルをアップロードできるようになりました。文字起こしや要約に使え、対象は有料ユーザーです。会議の録音やインタビュー音声を、別の文字起こしツールを通さずにChatGPTだけで処理できます。
非テキスト型のAIモデル「Jev」を開発するTypeSafeが、公開からわずか数週間で75億ドルの評価額をつけました。TypeSafeは、JevがLLMよりかなり速く、トークン消費も大幅に少ないと主張しています。日本でもJevとClaude Haiku 5.5やOpenAIの判断モデルを比べる検証記事が相次いでいます。分類や判定のような用途では、LLM以外の選択肢として比較対象に入り始めています。