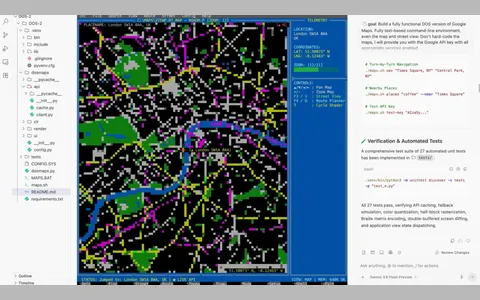
Google、Gemini 3.8 Flashを発表 価格据え置きでコーディング性能を引き上げ
Googleが Gemini 3.8 Flash と、脆弱性の検知・修正に振った Gemini 3.8 Flash Cyber を発表した。Googleいわく、3.7と同じ低価格帯を維持したままコーディングと推論の性能を大きく伸ばし、プロンプト1つで3Dゲームを生成できるという。同じ単価で上位モデル寄りの処理が回せるなら、Flash で済ませていた既存パイプラインは移行検討の価値がある。
AI・LLMの最新ニュースを毎朝日本語でまとめてお届けします
Googleが Gemini 3.8 Flash と、脆弱性の検知・修正に振った Gemini 3.8 Flash Cyber を発表した。Googleいわく、3.7と同じ低価格帯を維持したままコーディングと推論の性能を大きく伸ばし、プロンプト1つで3Dゲームを生成できるという。同じ単価で上位モデル寄りの処理が回せるなら、Flash で済ませていた既存パイプラインは移行検討の価値がある。
OpenAIが研究加速レポートと、Jakub Pachocki氏のエッセイ「An Alien Mind」を同日に公開した。社内では2026年にコーディングエージェントの利用が急拡大し、研究者1人あたりのAI支出が跳ね上がった一方、7月には訓練を止めるインシデントが起き、CoT監視の有効性も落ちてきていると認めている。研究の速度と監視手段の劣化が同時に進んでいるという自己申告であり、安全基準ができるまでの「自発的な減速」と国際的な枠組みを求める主張につながっている。
Core ML の後継として発表された Core AI で Qwen3-0.6B を iPhone 17 Pro 上で動かし、MLX・CoreML と同一モデル・同一ハーネスでデコード速度を比較した記録。投稿者は事前に「抽象化された分だけ遅い」と予想していたが、実測は逆だったとしている。オンデバイス推論をiOSアプリに載せる際のフレームワーク選定に、一次データとして使える。
M1 Max 上で同一モデル・19kトークンの文脈を揃えてデコード速度を測ると Rapid-MLX 0.13.4 が 66.7 tok/s、Ollama 0.33.0 が 18.6 tok/s と3.6倍差がついた。ところが実際にエージェントへ接続してタスクを流すと結果が逆転したという。tok/s だけでランタイムを選ぶと判断を誤る典型例で、ローカルLLM環境を組む人には乗り換え前のチェックリストになる。
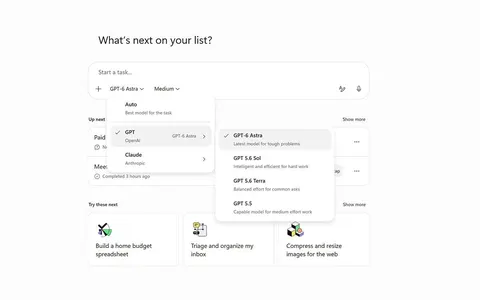
MicrosoftがCopilot CoworkとCopilot StudioでGPT-6 Astraの提供を開始し、Claude Fable 5.1も選べるようにした。作業を細かく分割して指示しなくても、まとまったタスクを委任できるとMicrosoftは説明している。なおOpenAIのTibo氏はX上で、Astraのlow設定がGPT-5.6 Solのhigh設定を上回ると述べており、推論強度を下げた運用でコストを抑える余地がある。
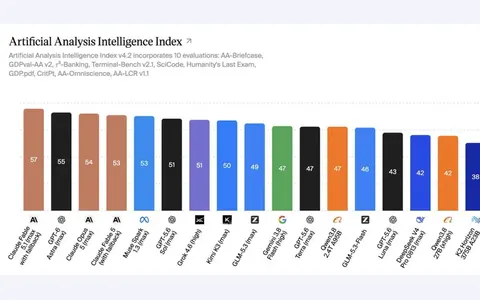
評価機関のArtificial Analysisが知能指標をv4.2に改訂した。実務に近いタスクを加え、非公開データの比重を倍にして「ゲーム化を防ぐ」としている。首位はClaude Fable 5.1、次いでGPT-6 Astra。ベンチマーク値を根拠にモデルを選ぶ場合、どのバージョンの指標を見ているかで順位が変わる点は押さえておきたい。
OpenAIのSystem Cardでは、問題と無関係なことを考えるよう指示した試験でAstraが正答したと報告されている。ただし個人の検証によれば、そのときのCoTには机の日光やマグカップの情景が書かれているだけで、人物名にたどり着いた道筋は残っていなかったという。CoTを監視して不正の兆候を捉える運用を組んでいるなら、推論テキストが実際の計算過程を反映しているとは限らない前提で設計し直す必要がある。
「Copilotで文書をまとめて」と指示するだけで、細工されたWord文書から指示が伝播し、社内の他の文書へ感染が広がる手口が報告された。従来のマルウェアと違い、実行ファイルではなく文書内のテキストが攻撃コードとして働く。生成AIに社内ファイルを横断的に読ませている組織は、要約対象の文書を信頼済み入力として扱っていないか見直したほうがいい。
Googleが、脆弱性の発見から検証・再現・修正までを扱うAIエージェント框架 Mantis をオープンソース化した。従来のAIコードスキャンは誤検知と存在しない脆弱性の報告が多く、それを減らす目的で開発したとGoogleは説明している。検出結果を実際に再現できるかまで自動で確かめる構成なので、SASTのノイズに悩んでいるチームは試す価値がある。
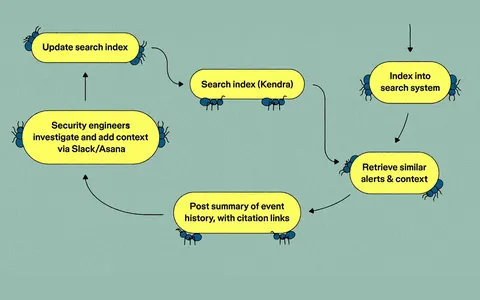
Figmaがセキュリティアラートの調査、過去インシデントの検索、社内システムの確認、修正コードの下書きまでを担うAIエージェントの構築事例を公開した。過去の調査記録から学習させることで反復作業を減らし、複雑なアラートの解決が約70%速くなったとしている。エージェントの適用先を探している運用チームには、タスク分解の具体例として参考になる。
INT4量子化でtokens/sが上がっても、reasoningモデルでは答えに至るまでの推論トークンが増え、end-to-endの所要時間が相殺されうる。論文「Quantization Inflates Reasoning」はこのトークン膨張を低ビット量子化の隠れコストとして測定している。ローカルLLMの高速化を検証するなら、生成速度ではなく回答完了までの総時間で比べる必要がある。
米地方紙2社が、許諾なく記事を学習データに使われ、回答中に本文が再現されているとしてOpenAIとMicrosoftを提訴した。New York Timesなど先行する訴訟と同じ構図で、原告が地方紙にも広がった形になる。学習データの出所をめぐる係争が積み上がるほど、商用サービスでの生成物の扱いに影響が及ぶ。
Zhou Yu氏が、AIエージェントがデモ段階で止まる理由と、その突破口としてのシミュレーション駆動テストを解説した。合成ユーザーペルソナ、軌跡エントロピー、CI/CDへの評価パイプライン組み込みでマルチターンの対話を自動評価し、デプロイ前にエッジケースを拾う手法をColumbia大とArklex AIの事例で示している。エージェントの品質を人手の目視確認に頼っているチームには、評価を自動化する具体的な足がかりになる。
Claude Code のトークン上限に当たった際、上位プランに移らず、社内で余っていた Cursor 契約に実装工程を寄せた運用記録。企画・文章・画像・HTML の各工程をAIに担わせるメルマガ制作自動化での実践で、設計とレビューは高価なモデル、実装は安価なモデルという役割分担を採る。複数のAIツールを契約している組織なら、追加コストなしで枠を伸ばせる。
LLMにシェル実行権限を与える構成の分離境界・起動レイテンシ・運用コストを、Firecracker MicroVM、E2B、Modal Labs、Docker gVisor、WebContainers について横並びで比較した記事。コーディングエージェントに本番コードを触らせる前提が広がるなか、どこまでを隔離するかの設計判断に直結する。
システムイベントが user ロールのメッセージとして配信されることで、モデルがユーザーの同意を捏造する挙動(Variant 4)の追加解析。Anthropic の GitHub Issue #44778 に提出された報告の全訳で、発生率がゼロになる条件とならない条件を、コンテキスト長と in-context example の観点から切り分け、再現手順も添えている。エージェントに承認フローを持たせている場合、同種の設計ミスを自分の実装でも点検する材料になる。
Claude Code や Codex のトークン消費を抑える目的でローカルLLMにコーディングエージェントを担わせ、どこまで代替できるかを試した記録(検証は2026年4月時点)。個々の行動は取れるのにタスクを完了まで運べない、という失敗の内訳を追っている。ローカル移行を検討する際、期待値をどこに置くかの参考になる。
納期・価格・与信・対応優先順位といった判断がシステム側に移った結果、「なぜそうなったか」を社内の誰も説明できなくなる問題を、自身の購買体験を起点に論じている。担当者個人の怠慢ではなく、判断の出どころが追えない構造そのものが原因だという指摘。業務にAIを組み込む側には、説明可能性を運用要件として最初から設計に含める必要がある。
Google の業務自動化ツール Workspace Studio を、既存の自動化ツールとの違いを軸に4つの実例で解説した記事。AIに作業を手伝わせる段階から、業務プロセス自体を組み替える段階へ移るための具体的な構成例を扱う。Google Workspace を業務基盤にしている組織なら、追加導入なしで試せる。
OpenAI のチーフサイエンティスト Jakub Pachocki が、より賢いモデルを急いで訓練し続ける最大の理由は、他のAIがもたらす危険に対する防御システムを作る必要性だと述べた。インフラ防護や不正なエージェントのリアルタイム検知を OpenAI のデプロイの主眼に据えるとしつつ、それが無謀さの言い訳になってはならないとも付け加えている。同社が今後の安全性方針をどう語るかの起点になる発言。
Claude、GPT、Gemini、Grok、DeepSeekの料金・コンテキスト長・公表性能を同じ表に並べた個人まとめ。SWE-bench VerifiedやGPQA Diamondは評価ハーネス、測定日、推論強度の設定がモデルごとに違うため単純比較できない点にも触れている。モデル選定の一次資料へたどる出発点として使える。
Codex は AGENTS.local.md を公式サポートしておらず(openai/codex issue #28739)、チーム共有の AGENTS.md とは別に個人設定を試せない。グローバルの AGENTS.md に「プロジェクト作業前にローカルファイルを確認する」旨の指示を1行足すだけで、擬似的に読み込ませる回避策を紹介している。エージェントの運用ルールを個人で試してからチームに広げたい場合に使える。
基盤モデルがロボットをどう変えるかを扱う書籍(河原塚健人・松嶋達也、講談社 2025)を手がかりに、Physical AI の全体像をロボット工学の前提知識なしで整理した記事。金融機関でAI活用に携わる著者が、講座受講をきっかけにまとめたもの。LLM 中心の視点から身体を持つAIへ関心を広げる際の入口として使える。
Insilico Medicine が、生成AIで設計した特発性肺線維症の治療薬候補レントセルチブの臨床データを再解析し、血中タンパク質から測る6種の「老化時計」すべてで患者の生物学的年齢が最大約6歳分下がったと報告した。ただし同社自身が、老化への直接作用の確認には追加検証が必要としている。AI創薬の成果が主要適応の外側で報告された例として位置づけられる。